
Visualização e exploração
Dashboards, investigação, correlação, alerting e múltiplos data sources.
A Add Solution utiliza o ecossistema Grafana Labs para construir arquiteturas modernas de observabilidade capazes de conectar métricas, logs, traces, profiles, aplicações, infraestrutura, cloud e experiência digital em uma visão operacional integrada.
Da instrumentação com OpenTelemetry e Grafana Alloy à arquitetura de Prometheus/Mimir, Loki, Tempo e Pyroscope, projetamos ambientes capazes de transformar telemetria em contexto para investigação, SRE e tomada de decisão.
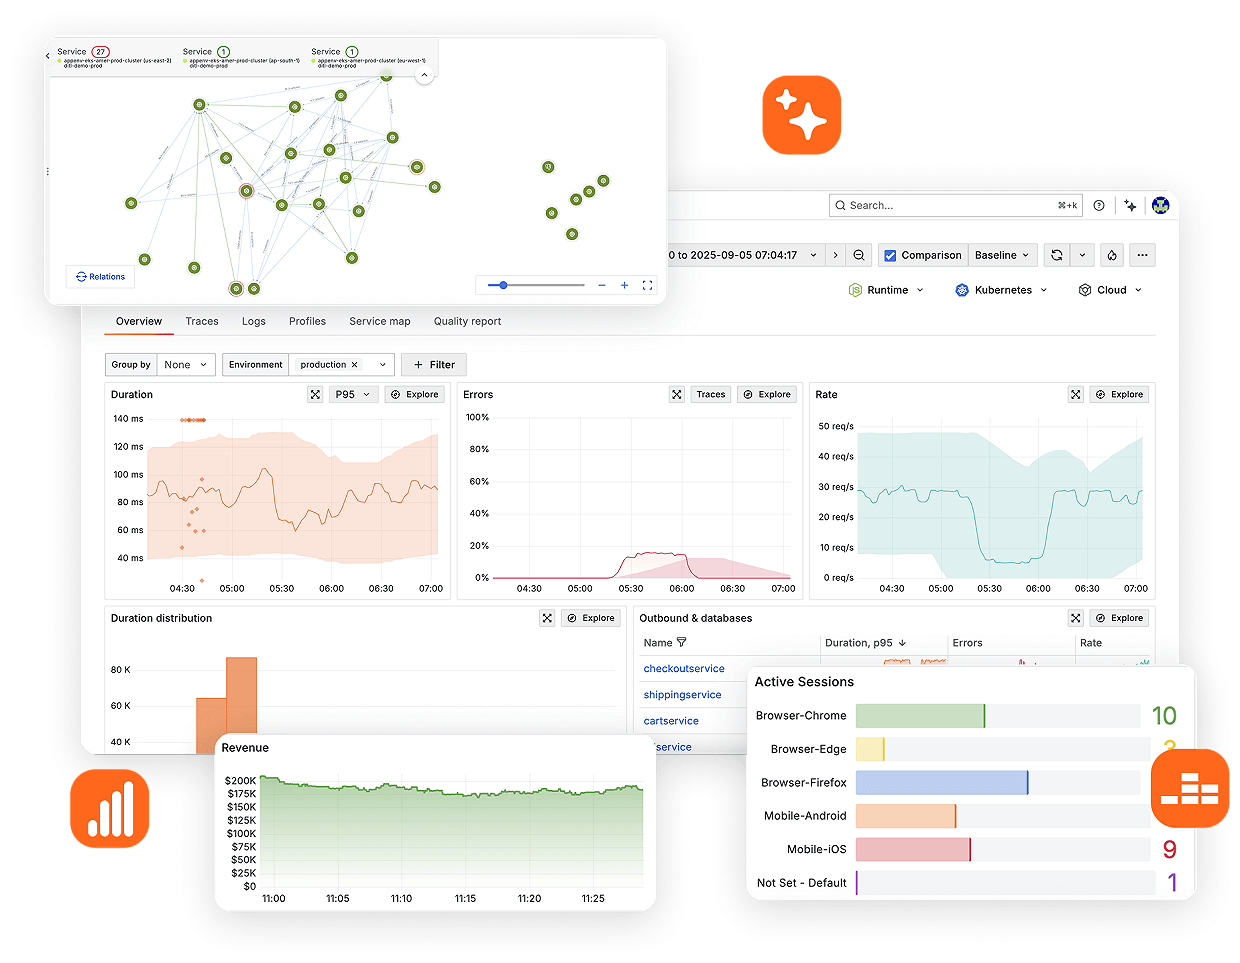
Antes de existir um gráfico, é preciso decidir o que observar, como instrumentar, onde coletar, como transportar e normalizar, quanto reter, como relacionar sinais, o que alertar e qual serviço aquilo representa. Só então faz sentido decidir como visualizar.
Aplicações, infraestrutura, Kubernetes, cloud, bancos e frontend.
OpenTelemetry, Prometheus e bibliotecas adequadas ao sinal.
Receber, processar, enriquecer, filtrar e rotear.
Metrics, logs, traces e profiles.
Mimir, Loki, Tempo, Pyroscope ou Grafana Cloud.
Grafana correlaciona, investiga, alerta e apoia decisões.
Grafana é onde muita gente vê os dados. Observabilidade começa muito antes do dashboard.
Grafana explora e visualiza diferentes fontes; Mimir escala métricas compatíveis com Prometheus; Loki agrega logs; Tempo armazena traces; Pyroscope recebe profiles; Alloy constrói pipelines de telemetria. LGTM descreve Loki, Grafana, Tempo e Mimir, enquanto profiling permanece um sinal complementar importante.
Dashboards, investigação, correlação, alerting e múltiplos data sources.
Backend Prometheus-compatible, multi-tenant e orientado a retenção longa.
Agregação baseada em labels, exploração com LogQL e correlação.
Backend de traces com object storage, TraceQL e geração de métricas.
Perfis de CPU, memória e outros recursos correlacionados aos demais sinais.
Collector unificado para métricas, logs, traces e profiles.
Grafana Alloy é um collector open source mantido pela Grafana Labs e uma distribuição do OpenTelemetry Collector com pipelines Prometheus e suporte integrado a Loki, Pyroscope e outros backends. Para novas arquiteturas, substitui o Grafana Agent, encerrado em 2025.
Aplicações, hosts, Kubernetes, cloud, bancos e logs.
Scraping, OTLP, exporters e integrações.
Relabeling, filtering, batching e transformação.
Metadados de serviço, ambiente e ownership.
Mimir, Loki, Tempo, Pyroscope, Grafana Cloud ou backends compatíveis.
A instrumentação deveria sobreviver à escolha do backend.
Prometheus é um projeto open source da CNCF, fundamental para métricas, scraping, service discovery, exporters e PromQL. Grafana Mimir estende o modelo Prometheus para escala horizontal, multi-tenancy e retenção longa. Loki organiza logs por labels e permite exploração com LogQL.
Scraping, exporters, service discovery, rules e remote_write conforme arquitetura.
Compatibilidade PromQL, escala horizontal, HA e object storage.
Labels consistentes, streams, retenção e padrões de consulta orientados ao uso.
Métricas apontam comportamento; logs registram o detalhe operacional.
Grafana Tempo recebe distributed traces via OpenTelemetry e permite consultar relações, dependências e caminhos com TraceQL. Grafana Pyroscope adiciona continuous profiling para identificar onde código, bibliotecas e runtime consomem recursos.
A experiência que iniciou a transação.
Entrada, roteamento e autenticação.
Spans, dependências, latência e erro.
Consultas e esperas no caminho crítico.
Funções e recursos consumidos durante a execução.
Metrics mostram que o consumo aumentou. Traces mostram onde a requisição passou. Profiles ajudam a revelar onde o código está gastando recursos.
Grafana Cloud Application Observability é OpenTelemetry-native e conecta serviços, latência, erros, traces, métricas RED, relações e profiles. A qualidade depende da instrumentação, convenções semânticas, sampling e metadados consistentes. A disponibilidade de Application Observability e recursos associados depende da modalidade e do plano contratados.
Jornada e resultado percebido.
Navegação, erros e client-side traces.
Entrada e contrato do serviço.
Dependências distribuídas e métricas RED.
Banco, cache, filas e serviços externos.
Frontend Observability utiliza RUM, Web Vitals, erros JavaScript, navegação, interações, browser logs e client-side traces. Synthetic Monitoring executa HTTP, DNS, TCP, ping e jornadas em navegador, inclusive com probes privados quando aplicável. SLOs traduzem disponibilidade, latência e erros em objetivos operacionais. Frontend Observability, Synthetic Monitoring, probes privados e recursos de SLO dependem da modalidade, do plano e da configuração aplicáveis.
Grafana Faro/Web SDK e OpenTelemetry conectam sinais do browser ao backend instrumentado.
Checks e browser journeys identificam falhas antes do relato do usuário.
SLI, error budget e burn rate orientam confiabilidade e alerting.
Rules, routing, contact points, silences e políticas sem alertar tudo.
Linux, Windows, VMs, containers, serviços e sinais de rede podem ser observados por integrações e pipelines adequados. Grafana Cloud oferece soluções para AWS, Microsoft Azure e Google Cloud, enquanto arquiteturas self-managed podem compor os mesmos sinais conforme projeto.
Sistema, processos, capacidade e eventos.
Workloads efêmeros e dependências.
Serviços gerenciados, contas e regiões.
Traces, métricas e logs do serviço.
Sinais correlacionados ao impacto operacional.
Kubernetes Monitoring relaciona clusters, nodes, namespaces, workloads, pods, containers, eventos, logs, métricas, traces e contexto de recursos. Database Observability acompanha PostgreSQL, MySQL e SQL Server conforme suporte atual, incluindo métricas, query samples, performance, wait events, schemas e planos.
Alloy e OpenTelemetry acompanham workloads e sinais que mudam com o scheduler.
Métricas e amostras ajudam a compreender qual workload está causando degradação.
Requests, limits, uso e eficiência precisam ser analisados em conjunto.
Adaptive Metrics, Logs, Traces e Profiles no Grafana Cloud ajudam a analisar uso e valor dos sinais, reduzir volume de baixo valor e preservar capacidade de investigação. Grafana Assistant utiliza IA para apoiar troubleshooting, analytics, criação e orientação, mantendo o engenheiro no centro da decisão. Adaptive Telemetry e Grafana Assistant são recursos sujeitos à oferta, ao plano e às condições vigentes do Grafana Cloud.
Sinais com volume, cardinalidade e custo.
Serviço, criticidade, uso e retenção.
Pergunta operacional ou hipótese.
Apoio à investigação e análise.
Validação, decisão e responsabilidade.
Coletar tudo é fácil. Definir o que vale a pena manter exige engenharia.
Uma arquitetura confiável exige decisões sobre instrumentação, collectors, labels, cardinalidade, storage, retention, sampling, queries, alertas, SLOs, correlação, segurança, alta disponibilidade, custos e processos. A Add Solution começa perguntando o que a operação precisa conseguir responder.
Serviço, ambiente, owner, resource attributes e timestamps sustentam correlação.
Labels precisam preservar utilidade sem comprometer custo e desempenho.
Volume, criticidade, erros, latência e investigação orientam a estratégia.
Operação, SRE, gestão e executivo recebem contextos diferentes conforme escopo.
Dashboard é apresentação. Observabilidade é engenharia.
Projetamos Grafana Cloud, stacks self-managed ou arquiteturas híbridas conforme funcionalidade, licenciamento e requisitos. Sizing considera séries ativas, cardinalidade, samples, logs por dia, spans, profiles, retenção, consultas, dashboards, alertas, crescimento, HA e object storage.
A engenharia considera scraping, exporters, remote_write, recording rules, ingestão e retenção Loki, OTLP e sampling Tempo, coleta Pyroscope, object storage, HA, load balancing, segurança, meta-monitoring, configuration as code e GitOps conforme necessidade.
PromQL, LogQL, TraceQL, labels, recording rules e padrões de uso orientam tuning.
Identidades, secrets, TLS, receivers e permissões definidos por componente.
Grafana Agent para Alloy, OTel, alertas, dashboards, Cloud e backends modernizados por etapas.
Observar, detectar, correlacionar, investigar, responder e aprender com processos definidos.
Zabbix acrescenta monitoring operacional; Elastic oferece search e correlação; Progress Flowmon aprofunda flows e comportamento de rede; Lansweeper adiciona asset intelligence. Grafana conecta múltiplas fontes e sinais. As relações dependem do projeto e não representam integração nativa universal.
A Add Solution pode avaliar métricas, logs, traces, OpenTelemetry, Prometheus, Grafana, retenção, cardinalidade, alertas e SLOs para identificar lacunas e oportunidades de evolução.
A Add Solution conecta observability engineering, padrões abertos, cloud native, SRE, telemetry economics e contexto de negócio para transformar sinais em capacidade de investigação e ação.
Arquitetura reduz acoplamento desnecessário entre aplicações e backend.
Kubernetes, containers, cloud, aplicações e bancos no mesmo contexto.
SLO, error budgets, alerting e investigação orientados ao serviço.
Componentes técnicos relacionados aos serviços que sustentam o negócio.
Respostas sobre coleta, componentes, modalidades, cardinalidade, acesso, disponibilidade e avaliação Grafana.
A coleta depende de instrumentação, exporters, agentes ou integrações apropriadas. O Grafana consulta as fontes configuradas. Primeiro valide a chegada dos dados; depois confirme que o painel consulta o sinal correto. Veja as fontes (https://grafana.com/docs/grafana/latest/datasources/).
A composição depende dos sinais e das bases existentes. É possível começar com uma fonte compatível e ampliar conforme a necessidade. Cada backend acrescentado traz responsabilidades de capacidade e operação. Entenda o Grafana (https://grafana.com/docs/grafana/latest/introduction/).
Compartilham a base, mas diferem em operação e recursos comerciais ou gerenciados. Compare a edição e o plano em uso, principalmente para plugins, controles de acesso e suporte. Compare as modalidades (https://grafana.com/docs/learning-hub/which-grafana/01-intro/02-the-grafana-landscape/).
O padrão facilita interoperabilidade, mas ainda é preciso definir componentes, atributos, destinos e comportamento em falhas. A configuração depende dos sinais e da distribuição adotada. Conheça os componentes (https://opentelemetry.io/docs/collector/components/).
Ele pode gerar muitas combinações quando usado como label. No Loki, prefira o mecanismo adequado de metadados para campos de alta cardinalidade e avalie a necessidade de armazenar esse dado. Veja cardinalidade (https://grafana.com/docs/loki/latest/get-started/labels/cardinality/).
Não presuma essa equivalência. Permissões de dashboards e autorização de consultas são controles distintos. Verifique a edição, as permissões da fonte e o acesso concedido à conexão. Confira o controle de fontes (https://grafana.com/docs/grafana/latest/administration/data-source-management/).
São necessidades diferentes. A arquitetura distribui a operação; o backup permite recuperar estado após situações como alterações indevidas ou corrupção. Teste a restauração do Grafana e trate os backends separadamente. Consulte backup (https://grafana.com/docs/grafana/latest/administration/back-up-grafana/).
Escolha um serviço, duas ou três perguntas operacionais e critérios de aceitação. Meça ingestão, consultas, cobertura e entrega de alertas durante um ciclo representativo. Use os resultados para dimensionar a expansão e a contratação. Consulte consumo no Cloud (https://grafana.com/docs/grafana-cloud/platform/pricing-and-usage/).
Converse com nossos especialistas sobre Grafana, Prometheus, OpenTelemetry, Alloy, Loki, Tempo, Mimir, Pyroscope, aplicações, Kubernetes, cloud, SLO e arquiteturas modernas de observabilidade.