Interoperabilidad
Los protocolos y formatos abiertos mantienen las opciones de integración.
Add Solution utiliza OpenSearch para construir arquitecturas modernas de observabilidad capaces de ingerir, buscar, correlacionar y analizar registros, métricas y trazas de aplicaciones, infraestructura y entornos distribuidos.
Desde la instrumentación con OpenTelemetry hasta los pipelines con Data Prepper, la arquitectura de clústeres, la retención, los paneles, APM, las alertas y el análisis operativo, diseñamos entornos OpenSearch para convertir grandes volúmenes de telemetría en información útil para la investigación y la toma de decisiones.
Una aplicación se ralentiza. Un log registra un timeout, una métrica muestra un aumento de latencia, una traza revela la dependencia y un mapa de servicios expone la relación. La búsqueda recorre estas señales para transformar evidencias aisladas en una explicación operativa.
Registran evidencias, errores y cambios de estado.
Muestran el comportamiento y las tendencias a lo largo del tiempo.
Reconstruyen la ruta de una transacción distribuida.
Investiga preguntas que ningún dashboard había previsto.
Relaciona señales por servicio, recurso y contexto.
Convierte la comprensión en decisiones operativas.
Almacenar telemetría permite consultar los datos. La observabilidad comienza cuando podemos relacionarlos para explicar el comportamiento del entorno.
OpenSearch es una suite de código abierto bajo Apache License 2.0 para búsqueda, análisis, observabilidad y búsqueda vectorial. La transparencia, la extensibilidad, la interoperabilidad y la flexibilidad de implantación reducen las dependencias propietarias, pero no eliminan las decisiones de arquitectura, capacidad, seguridad y operación. La licencia Apache 2.0 del proyecto no hace que la infraestructura, la operación, el soporte o los servicios gestionados sean gratuitos, ni demuestra una compatibilidad universal.
Los protocolos y formatos abiertos mantienen las opciones de integración.
Componentes, datos y ciclos de evolución definidos según la operación.
Los plugins, las API y los pipelines permiten combinar componentes según el caso de uso.
OpenSearch Observability Stack combina OpenTelemetry Collector, Data Prepper, OpenSearch, Prometheus y OpenSearch Dashboards. Las trazas y los logs se procesan para OpenSearch; las métricas de series temporales pueden enviarse a Prometheus y consultarse con PromQL.
Servicios, contenedores, nube y agentes de IA.
Instrumentación, convenciones semánticas y OTLP.
Procesar, enriquecer, correlacionar y enrutar.
Logs y trazas que se pueden buscar; métricas de series temporales.
Búsqueda, PPL, PromQL, APM, mapas de servicios y alertas.
OpenTelemetry es un estándar de CNCF, independiente de OpenSearch, para generar, recopilar y exportar telemetría. Los SDK, Collector, OTLP y las convenciones semánticas aportan consistencia a los logs, las métricas y las trazas, y reducen el acoplamiento innecesario entre aplicaciones y plataformas.
Las aplicaciones producen señales con contexto semántico.
El protocolo transporta logs, métricas y trazas.
Recibe, procesa, agrupa y exporta telemetría.
Los atributos consistentes conectan recursos y servicios.
Las señales se envían a destinos adecuados para la arquitectura.
La instrumentación debería aportar contexto a la operación, no una dependencia innecesaria de una herramienta.
OpenSearch Data Prepper es un colector del lado del servidor y un motor de procesamiento que recibe datos, los filtra, transforma, normaliza, enriquece, agrega y enruta hacia sistemas posteriores. En observabilidad, prepara logs y trazas para la indexación, la correlación, los mapas de servicios y el análisis.
OTLP, flujos y fuentes adecuados para el pipeline.
Extraer campos de eventos no estructurados.
Estandarizar nombres, marcas de tiempo y atributos.
Añadir entorno, responsable, criticidad y recurso.
Dirigir las señales según las reglas y los destinos.
Preparar los datos para una búsqueda y un análisis eficientes.
La telemetría sin procesar ocupa espacio. La telemetría estructurada genera contexto.
Los logs estructurados permiten utilizar PPL, filtros y agregaciones; las métricas de Prometheus muestran el comportamiento mediante PromQL; las trazas de OpenTelemetry relacionan spans, dependencias, latencia y errores. La correlación nace de una identidad de servicio, identificadores de traza, recursos y contexto consistentes.
Ingesta, análisis sintáctico, patrones, retención, búsqueda y visualización.
Prometheus, PromQL, series temporales y métricas de aplicaciones e infraestructura.
Trazas, spans, servicios, dependencias, errores y latencia.
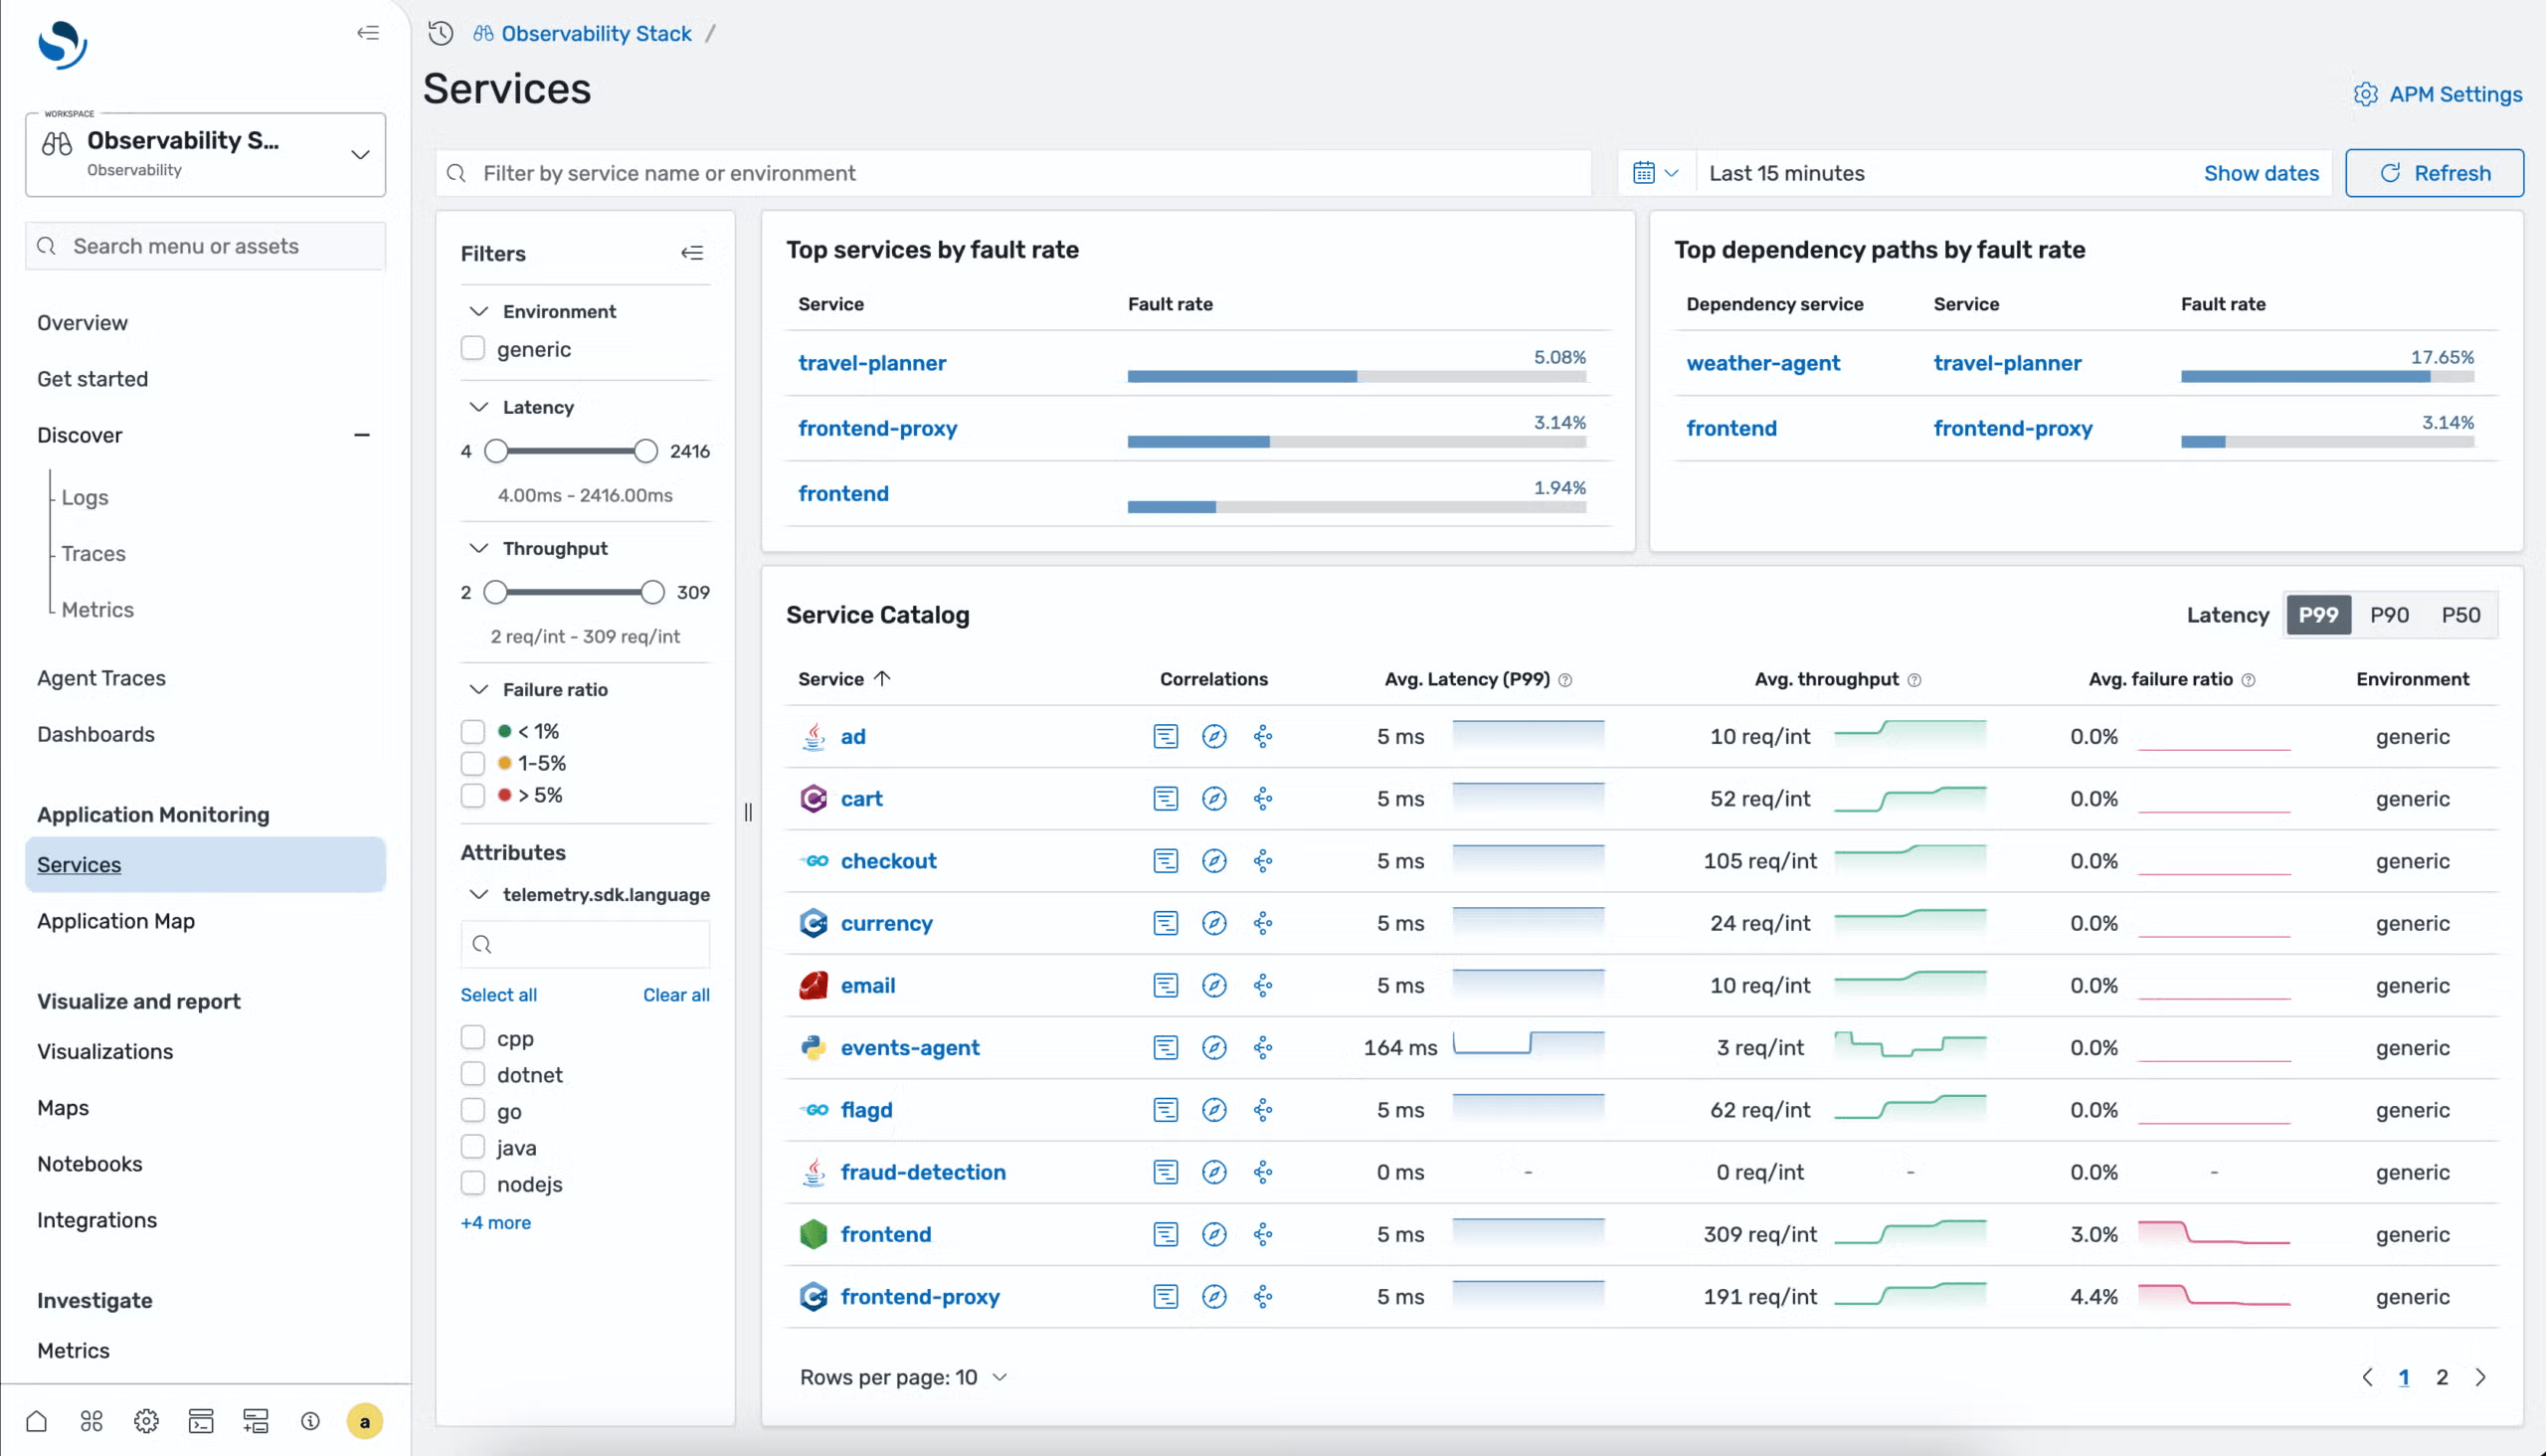
OpenSearch APM combina trazas y logs ingeridos mediante OpenTelemetry Collector y Data Prepper con métricas en Prometheus. El catálogo de servicios, el mapa de aplicaciones, las métricas RED, los errores y la latencia ayudan a investigar transacciones y dependencias distribuidas. La experiencia APM documentada se introdujo en OpenSearch 3.6 y depende de espacios de trabajo, flags y componentes compatibles; no debe atribuirse automáticamente a versiones anteriores ni a todas las modalidades de AWS.
Una acción inicia el recorrido observado.
El punto de entrada de la experiencia y el primer span.
Las llamadas recorren aplicaciones y dependencias.
La latencia y los errores aparecen en el contexto de la transacción.
La tasa de solicitudes, los errores y la duración ayudan a interpretar el comportamiento del servicio.
Application Analytics organiza logs, trazas y métricas en una vista del estado general del sistema. Los mapas de servicios muestran las relaciones; PPL investiga eventos; PromQL consulta métricas; Dashboards reúne visualización, exploración, gestión y vistas operativas.
Relaciones entre servicios, bases de datos y dependencias, con contexto RED.
Piped Processing Language permite analizar logs, trazas y eventos.
PPL, SQL, Query DSL y PromQL según los datos y el análisis.
Un dashboard muestra lo que hemos decidido supervisar. La búsqueda permite investigar lo que aún no sabemos.
La búsqueda de texto completo, la búsqueda estructurada, los filtros, las agregaciones y la investigación de alta dimensionalidad permiten explorar nuevas hipótesis. La fortaleza de OpenSearch consiste en hacer posible la búsqueda en grandes volúmenes de datos sin reducir la observabilidad a una colección fija de dashboards.
Durante el incidente surge una hipótesis.
El texto, los campos, el tiempo, el servicio y el recurso delimitan el alcance de la búsqueda.
Las agregaciones y PPL revelan patrones y relaciones.
Los logs y las trazas convergen mediante el contexto disponible.
El equipo construye una explicación verificable.
Anomaly Detection identifica desviaciones en series temporales sin prometer precisión absoluta. Alerting conecta la consulta, la condición, el monitor, el disparador, la acción y la notificación. Los SLO experimentales pueden seguir los SLI, el presupuesto de error y la tasa de consumo mediante un ruler compatible con Prometheus, sin confundir un SLO operativo con un SLA contractual. Anomaly Detection y Alerting ayudan en la detección y la respuesta, pero no garantizan la disponibilidad.
Series, eventos y consultas con contexto.
La desviación y el grado de anomalía ayudan en la investigación.
La regla explicita cuándo se requiere atención.
El monitor y el disparador generan un evento sobre el que se puede actuar.
Una notificación o integración inicia el proceso operativo.
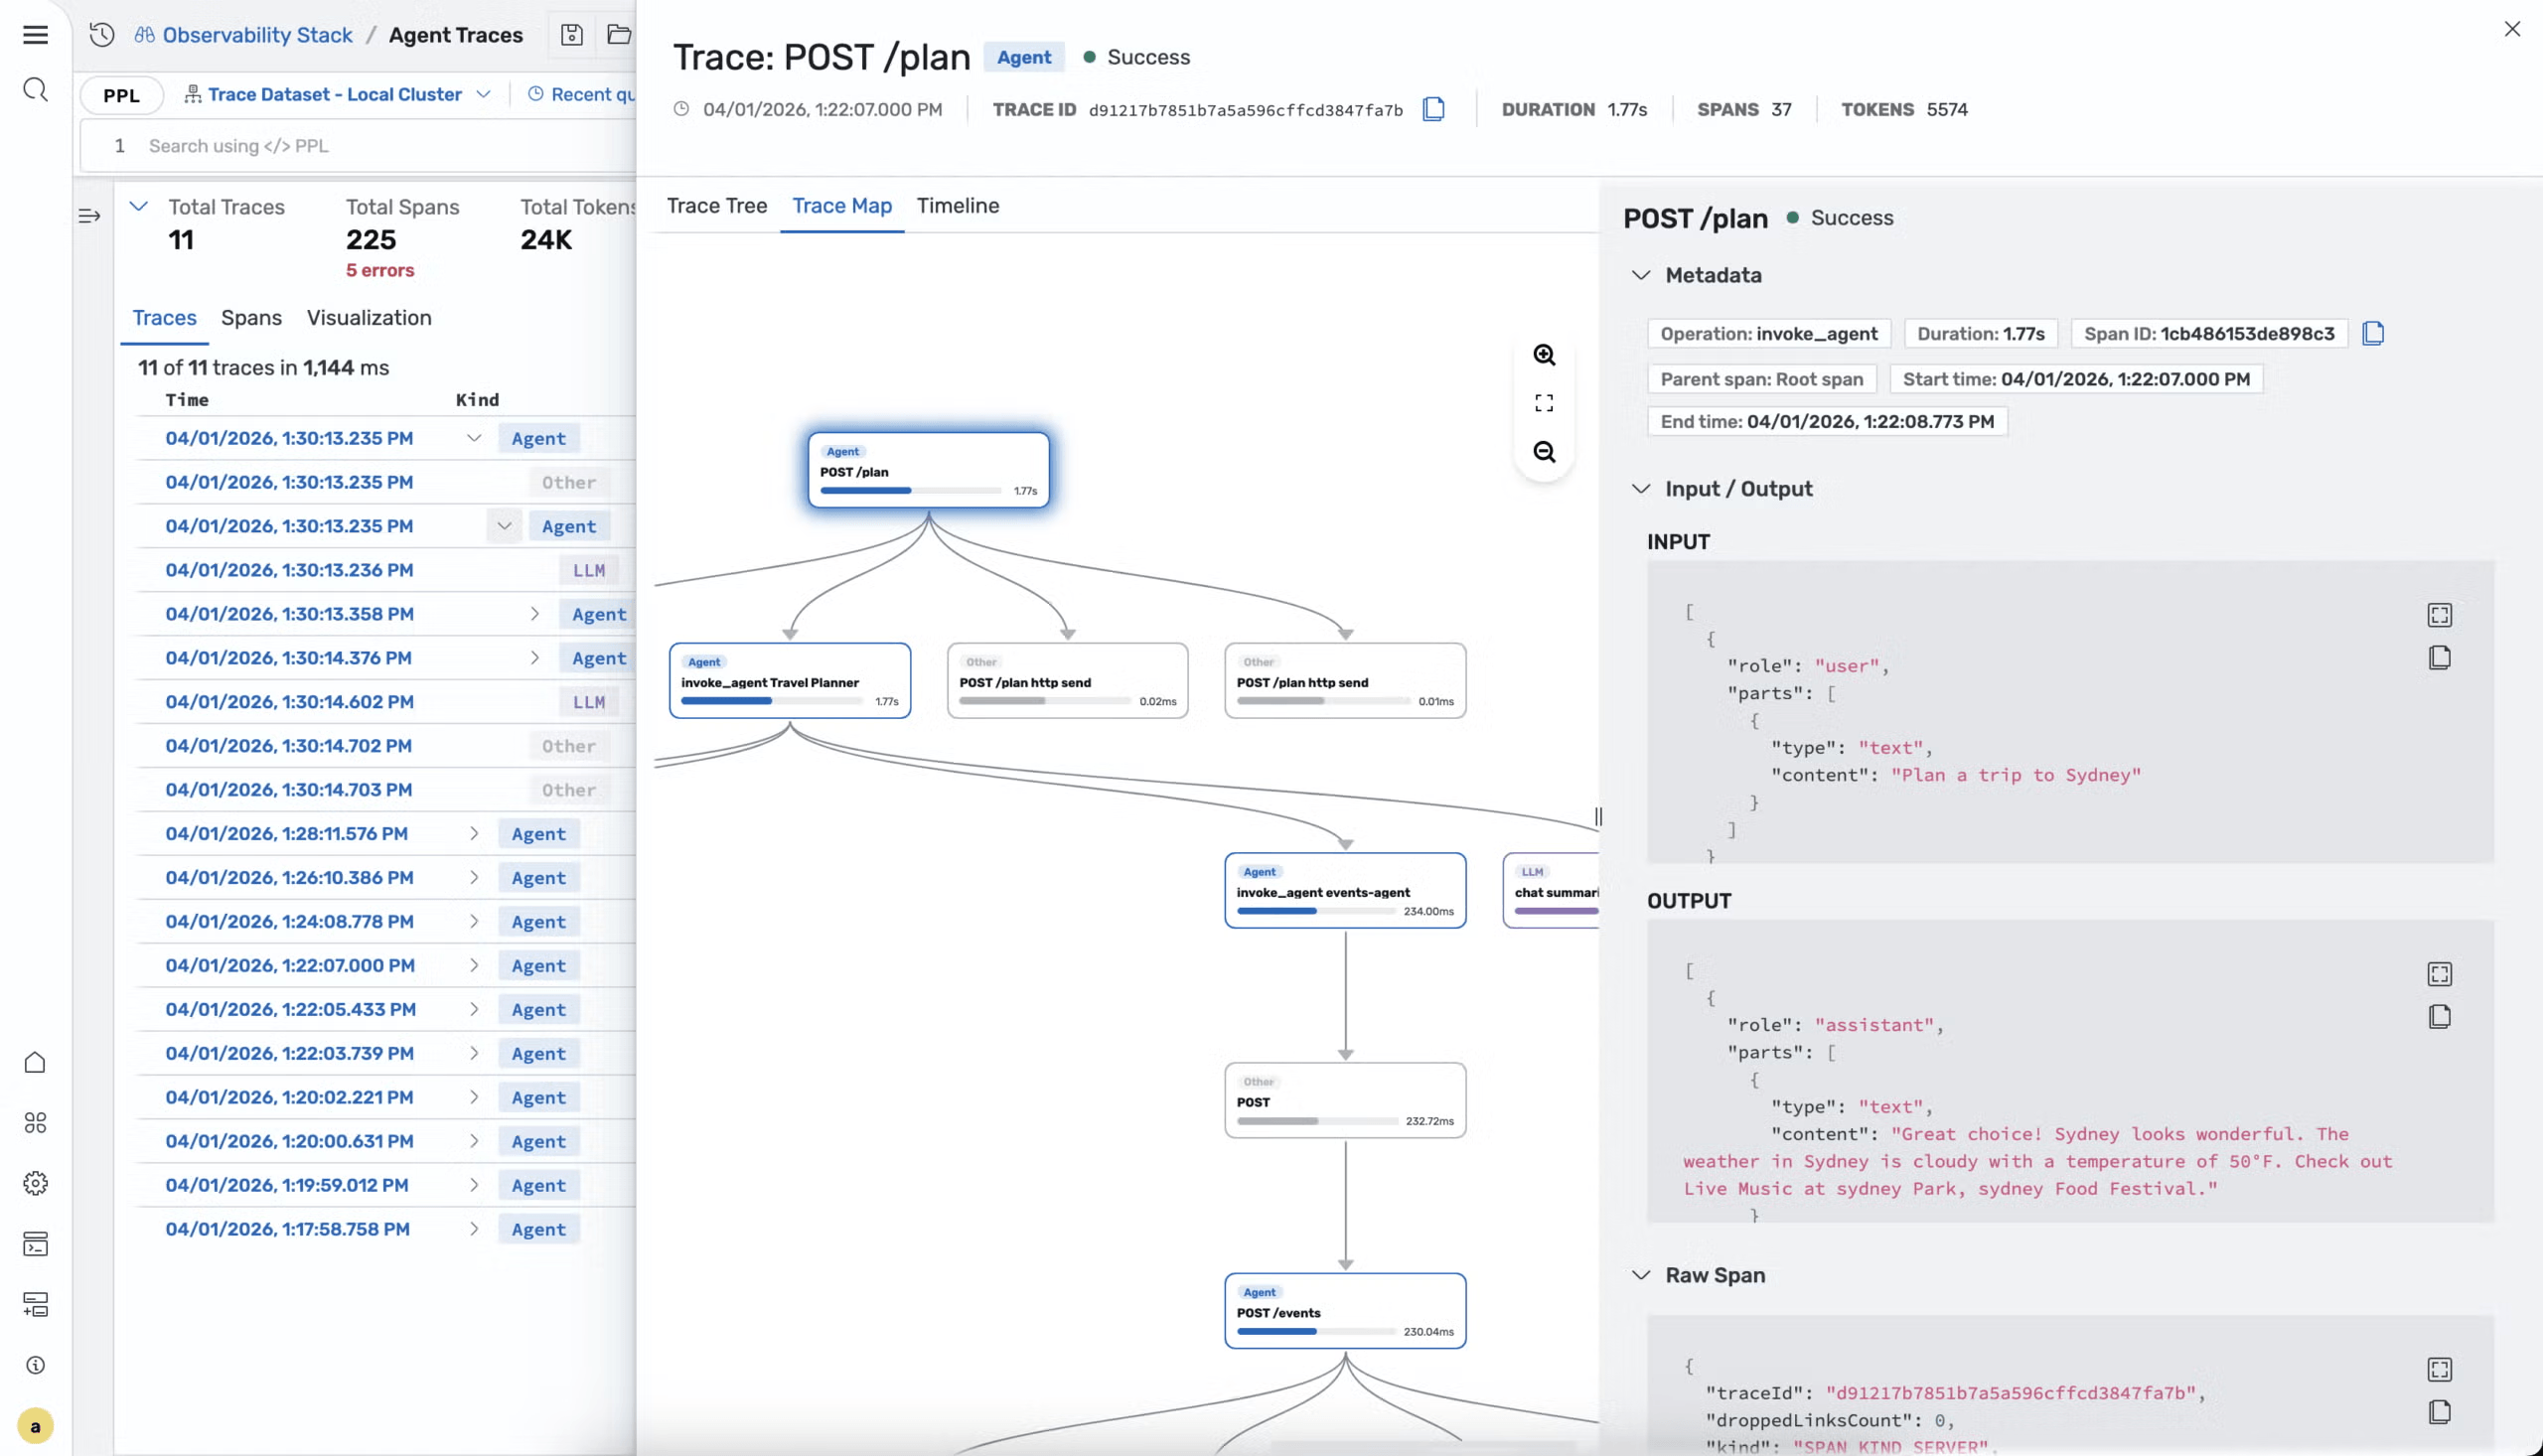
Agent Traces utiliza OpenTelemetry y las convenciones semánticas GenAI para observar ejecuciones jerárquicas, llamadas a LLM, herramientas, tokens, sesiones, errores y latencia. La interfaz permite explorar árboles, grafos, líneas de tiempo y métricas agregadas sin tratar la IA como una caja negra aislada.
Una solicitud inicia la ejecución.
Contexto, sesión y flujo de trabajo.
Decisiones y rutas de ejecución.
Modelo, tokens, llamadas, base de datos y API.
Latencia, errores, consumo y calidad observables.
Una aplicación de IA sigue siendo una aplicación distribuida. Solo añade nuevos componentes que también deben observarse.
Los grandes volúmenes de logs, métricas y trazas no garantizan la comprensión. Es necesario decidir qué recopilar y cómo instrumentar, normalizar, enriquecer, correlacionar, indexar, retener, buscar, generar alertas, proteger y operar. Add Solution trabaja a lo largo de toda esta cadena.
Nombres de servicios, entornos, marcas de tiempo, atributos de recursos, identificadores de traza y responsables.
Mappings, plantillas, shards, réplicas, alias, rollover y retención según los patrones de consulta.
Cómputo, memoria, almacenamiento, red, réplicas, instantáneas, copias de seguridad y crecimiento.
Nuestro trabajo no termina cuando los datos llegan a OpenSearch. Es entonces cuando comienza la ingeniería de observabilidad.
La evaluación, la estrategia, la arquitectura, el dimensionamiento, la instrumentación, la ingesta, la normalización, la indexación, la correlación, la visualización, las alertas, la operación y la evolución forman un único recorrido. El diseño considera aplicaciones, infraestructura, nube, Kubernetes, volúmenes, retención, seguridad, cumplimiento y procesos. OpenSearch autogestionado, Amazon OpenSearch Service y OpenSearch Serverless difieren en API, plugins, autenticación, capacidad, recuperación y facturación.
Entorno, señales, volúmenes, requisitos y carencias.
Clúster, Collector, Data Prepper, Prometheus y Dashboards.
GB/día, eventos, documentos, retención, consultas, HA y crecimiento.
OpenTelemetry, OTLP y atributos consistentes.
Análisis sintáctico, filtros, enriquecimiento, enrutamiento y muestreo.
Rendimiento, seguridad, instantáneas, alertas y evolución.
Add Solution diseña arquitecturas autogestionadas y evalúa ofertas gestionadas cuando corresponde, distinguiendo el proyecto OpenSearch de Amazon OpenSearch Service. No existe un diseño universal: las cargas de ingesta, búsqueda, análisis, observabilidad y búsqueda vectorial tienen requisitos diferentes.
Heap, JVM, indexación, shards, mappings, consultas, agregaciones, caché y almacenamiento.
Distribución de nodos, réplicas, dominios de fallo, instantáneas y recuperación.
Autenticación, autorización, RBAC, TLS, cifrado, auditoría y controles granulares.
Rollover, retención, instantáneas y mecanismos de almacenamiento según la arquitectura.
Add Solution puede evaluar la arquitectura, el clúster, la ingesta, Data Prepper, OpenTelemetry, los índices, los shards, la retención, el rendimiento, los logs, las trazas y los procesos de investigación. La migración desde Elasticsearch exige validar el origen y el destino, los clientes, los mappings, las API, los plugins, las instantáneas, los objetos visuales, la aplicación, la reversión y los criterios de aceptación; no consiste en un simple cambio de endpoint válido para todos los casos.
Add Solution combina ingeniería de observabilidad, búsqueda y análisis, OpenTelemetry, pipelines de datos, ingeniería de plataformas y contexto de negocio para transformar la telemetría en capacidad de investigación y acción.
Logs, métricas y trazas orientados a las preguntas de la operación.
Datos que se pueden buscar y relaciones verificables durante los incidentes.
Clúster, rendimiento, disponibilidad, seguridad, almacenamiento y retención.
Telemetría relacionada con lo que sostiene la operación.
Encontrar datos es una capacidad de búsqueda. Relacionarlos para comprender el comportamiento de un entorno es una capacidad de observabilidad.
Respuestas sobre modalidades, dimensionamiento, licencias, instantáneas, APM, migración, seguridad y búsqueda vectorial de OpenSearch.
OpenSearch es el proyecto de software. Amazon OpenSearch Service es una oferta comercial de AWS, con modalidades aprovisionada y Serverless. Las funciones, las responsabilidades y los precios deben verificarse en la modalidad elegida. Referencia de AWS (https://docs.aws.amazon.com/opensearch-service/latest/developerguide/serverless-comparison.html).
Depende del volumen indexado, la retención, las réplicas, el crecimiento y las características de los campos y las consultas. Una estimación debe incluir margen operativo y validarse mediante pruebas; el volumen bruto recibido por sí solo no basta para dimensionar. Referencia de dimensionamiento (https://docs.aws.amazon.com/opensearch-service/latest/developerguide/sizing-domains.html).
La licencia del proyecto no cobra por el uso del software. La infraestructura, los servicios gestionados, la operación y las integraciones pueden generar costes. Es importante comparar el coste total del entorno con supuestos explícitos. Licencia (https://opensearch.org/faq/) y precios de AWS (https://aws.amazon.com/opensearch-service/pricing/).
No. Las réplicas ayudan a mantener la disponibilidad, pero reproducen los cambios en los datos. Las instantáneas y las restauraciones probadas responden a las necesidades de recuperación. El plan debe prever fallos y eliminaciones, incluida la protección del repositorio. Referencia de instantáneas (https://docs.opensearch.org/latest/tuning-your-cluster/availability-and-recovery/snapshots/snapshot-restore/).
Es necesario recopilar y preparar la telemetría. APM depende de la instrumentación y de componentes compatibles, incluidos OpenTelemetry, Data Prepper y, en la arquitectura actual documentada, Prometheus para las métricas. Deben verificarse la cobertura y la calidad. Referencia de APM (https://docs.opensearch.org/latest/observing-your-data/apm/index/).
No existe compatibilidad universal. Las versiones, los clientes, los plugins, los mappings, las API y las instantáneas requieren evaluación. Ejecute un piloto con consultas y escrituras representativas antes de definir el cambio definitivo. Clientes (https://docs.opensearch.org/latest/clients/) y evaluación de la migración (https://docs.opensearch.org/latest/migration-assistant/migration-phases/assessment/).
Las funciones técnicas respaldan las políticas de acceso, protección y auditoría. Deben evaluarse su configuración, los procesos internos, la finalidad de los datos y las evidencias operativas. Utilizar OpenSearch, por sí solo, no demuestra el cumplimiento. Referencia de seguridad (https://docs.opensearch.org/latest/security/).
Puede intervenir en la recuperación de información, incluidas la búsqueda vectorial y la híbrida. La aplicación también necesita un modelo, preparación de datos, evaluación de calidad y controles de acceso. Deben considerarse los costes y las restricciones de las integraciones. Referencia de búsqueda vectorial (https://docs.opensearch.org/latest/vector-search/).
Hable con nuestros especialistas sobre OpenSearch, OpenTelemetry, Data Prepper, logs, trazas, métricas, APM, búsqueda, análisis, rendimiento y arquitecturas empresariales de observabilidad.